CRISPY AI 寫程式流程與 Instruction Budget
來源:愛好 AI 工程 Blog · 我錯了,還是要讀程式碼:Dex Horthy 重新檢討 AI 寫程式流程(2026-06-01)
模型沒有記憶,上下文的品質決定一切,所以千萬不要外包思考。改變的是把人的注意力從「讀冗長的計畫」轉移到「讀簡短的對齊文件 + 最終程式碼」。
由 Dex Horthy(HumanLayer)在實作半年後提出,是其原本 RPI(Research–Plan–Implement) 方法論的演進與認錯版本。
核心思想
RPI 的三個錯誤(作者親自認錯)
- 還是要讀程式碼:原本主張可跳過 code review/不讀 code,實作半年後下場不好,被迫大規模重寫。
- 計畫不該逐行讀:1,000 行計畫產出約 1,000 行 code,但實作常「飄移(drift)」,最後還是得重讀,沒省到時間。
- 不能產出 slop(粗製濫造):有真實後果的 production 系統,AI 生成的程式碼不能是垃圾。
核心矛盾:AI 產出量增加 50%,但其中約一半是 rework(修先前的錯),而非新功能。
為什麼 RPI 在規模化時失敗
- 跨數千名工程師測試後發現:AI 對全新、簡單的專案很強,但對有歷史包袱的 legacy 系統會失敗。
- 高手能跟 AI「黏在一起」(70 小時/週狂出貨),但同樣工具給團隊用結果平庸 → 問題在組織採用,不在個人。
CRISPY 八階段
| # | 階段 | 做什麼 |
|---|---|---|
| 1 | Questions | 該問什麼問題 |
| 2 | Research | 現況有什麼 |
| 3 | Design | 目標狀態是什麼 |
| 4 | Structure Outline | 怎麼到達(垂直切) |
| 5 | Plan | 逐行實作細節 |
| 6 | Worktree | 開分支 |
| 7 | Implement | 寫 code |
| 8 | Pull Request | 送審 |
首字母 QRSPI 不好記,所以改包裝成 CRISPY(脆,好記)。雖然嘴上說「三步」,實際演進成七到八步。
八階段又分成兩大塊:前五階段「研究與規劃」(Questions → Research → Design → Structure Outline → Plan)是人花時間對齊方向的地方;後三階段「動手實作」(Worktree → Implement → Pull Request)才真正寫 code、開分支、送審。
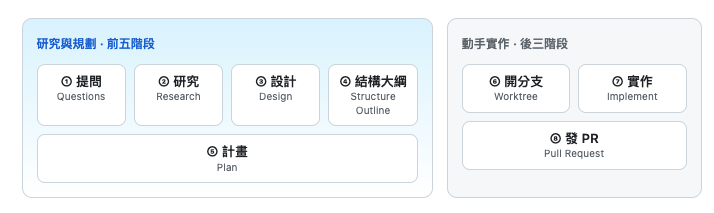
關鍵階段細節
- Design 文件(~200 行):捕捉現況、目標、既有慣例、已鎖定的決策、待解問題。這是「對 AI 動腦部手術」——逼它在寫 2,000+ 行 code 前先攤開假設。
- Structure Outline(~2 頁):像 C 的 header file(.h)——列出 function signature 與會動到的型別,不含完整實作。可在不讀整份計畫的情況下確認方向對不對。
- 垂直切片(不是水平):模型預設水平切(全部 DB → 全部 service → 全部 API → 全部前端),會先產出 1,200 行無法測試的 code。應改垂直切:每個增量都貫穿前端到資料庫,可立即測試。Structure Outline 用來強制這個紀律。
一個例子看懂四個階段的差別
以「在既有 SaaS 帳號系統加上雙因素驗證(2FA)」為例,看 Research / Design / Structure Outline / Plan 的顆粒度差異——整體是從「現況的廣面事實」收斂到「程式碼層級的細節」:
| 階段 | 篇幅 | 內容 | 人介入程度 |
|---|---|---|---|
| Research | — | 客觀調查現況事實:登入流程在哪、密碼怎麼驗、session 怎麼建、現有 SMS/email 機制、user data schema。不帶任何「2FA 該怎麼做」的意見。 | 低(純事實) |
| Design | ~200 行 | 訂方向與關鍵決策:支援 TOTP 還是 SMS、備用碼怎麼處理、強制還是 opt-in、session 失效規則。列出「已決定」與「待人回答的問題」。 | 高(對齊方向) |
| Structure Outline | ~2 頁 | 把工作切成垂直、可測試的增量:DB migration、TOTP 元件、API 介面、前端 UI。每個增量含測試方式,不含實作細節。 | 中(確認架構) |
| Plan | ~8 頁 | 實作規格:具體檔名、行號、code snippet,細到可直接照做。 | 低(掃過即可) |
→ 前面階段需要較多人類盯著對齊方向,最後的 code 產出則是「強制必讀」。
注意力該放哪
| 文件 | 怎麼讀 |
|---|---|
| ✅ Design + Outline | 對齊方向,認真看 |
| ⚠️ Plan | 快速掃過 |
| ✅ Code | 徹底讀 |
Instruction Budget(指令預算)
模型大約能可靠遵守 150–200 條指令;超過就開始不可靠、跳步驟。
- 範例:85 條指令的 prompt + 專案指令檔(如 agents.md / CLAUDE.md)+ system prompt + MCP 工具描述 → 預算爆掉,模型放棄多步驟流程。
- 含義:一直加 MCP 工具卻不修剪指令,邊際效益遞減——因為指令預算早就超載,MCP 工具描述本身也在吃預算。
解法一:用程式邏輯取代 prompt 分支
- 盡量用 code 控制 workflow,而不是在 prompt 裡塞 if-then。
- 與其一個 prompt 塞 85 條指令做分支(客訴走 A、帳務走 B),不如先用模型分類一次,再 route 到各自 <40 條指令的專用子 prompt。
解法二:用程式碼切分隔離意見
- Research 階段原本的指令「研究程式碼庫,我要做的功能是 OOO」會把意見(opinion)注入到本該是事實分析的環節。
- 解法:用程式碼切分而非 prompt。一個對話只產生「問題」;另一個完全獨立、不知道需求的對話,才去產生 research 文件。類比資料庫的 query planning。
「咒語」問題(Magic Spell)
- 超過 50% 的使用者會直接跳過討論階段,除非 prompt 明講:「先從你的疑問和大綱開始,不要急著寫計畫」。
- Dex 的洞見:「如果你做出來的工具,要花大量訓練才能用出好結果,那該被修的是工具(不是使用者)。」
對齊(Alignment)才是重點
- 較短的文件(Design 200 行 + Outline 2 頁)加速團隊對齊。在寫 code 前先把 design 分享給協作者,在情感投入與 code 產生前先抓出分歧。
- 結果:code review 變小,因為分歧早就在前期解決掉了。
Context Budget 補充
- 「笨蛋區」(40% context 的愚蠢門檻)對新手仍有效,但有經驗後可彈性:
- 新手:低於 40%,60% 前收尾
- 老手:可靠運作到 60%,依任務複雜度調整
- 靜態文件(design / outline / plan)能減少對 context 壓縮的依賴——關鍵資訊存在可讀檔案裡,而不是易逝的對話中。
務實的速度目標
- 目標是維持人類品質下的 2–3 倍,而不是帶著 slop 的 10 倍。
- 用爛 code 衝 10 倍、賭未來 AI 來修,商業結果比可持續的 2–3 倍更差。
開源例外
- 像 Beads(30 萬行)這類嗜好專案,可以不做逐行 PR review。
- 但:「如果有人是靠你的程式碼吃飯的……去讀它。」 嗜好專案與受監管的 production 系統,專業標準不同。